Inżynieria systemów oparta na modelach (MBSE) jest sformalizowaną metodologią, która jest używana do wspierania wymagań, projektowania, analizy, weryfikacji i walidacji związanych z rozwojem złożonych systemów. W przeciwieństwie do inżynierii skoncentrowanej na dokumentach, MBSE stawia modele w centrum projektowania systemu. Zwiększone przyjęcie środowisk modelowania cyfrowego w ciągu ostatnich kilku lat doprowadziło do zwiększonego przyjęcia MBSE. W styczniu 2020 roku NASA odnotowała ten trend, informując, że MBSE “jest coraz częściej przyjmowane zarówno przez przemysł, jak i rząd jako sposób na śledzenie złożoności systemu.” W tym wpisie na blogu przedstawiam krótkie wprowadzenie do MBSE.
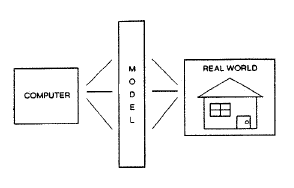
Smith, B. C. (1985). Computers, Models, and the Embedding World, The Limits of Correctness. SIGCAS Comput. Soc., 14,15(1,2,3,4), 18?26. doi: 10.1145/379486.379512
Pojawia się próba diagnozy. Pełna tak zwana śladowalność wymagań (nazwana tu hipertracebility) jest podobno kosztowna i trudna do utrzymania. Zaraz potem: niedbałość w definiowaniu wymagań - no to w końcu dokładnie czy nie? Kolej na analityków: zrzucanie odpowiedzialności ? analitycy tworzą dokument wymagań i wypychają go do programistów. Oczywiście jest to problem, co z tym? Analityk powinien ponosić odpowiedzialność za swój produkt do końca projektu. Założenie, że można stworzyć skończony dokument wymagań. Otóż można ale o tym za chwilę. Poza ważnymi elementami zarządzania takim projektem, w tym zarządzaniem zespołem autorzy wskazali jedną z głównych moim zdaniem przyczyn: brak dokumentu HLD (projektu wysokopoziomego).
Otóż nie da się czymś tak złożonym jak oprogramowanie (zakładam, że to nie trywialny system), zarządzać na poziomie detalicznych szczegółów.

Moim zdaniem hurtownie danych i wszelkiego typu systemy BI mogą być skuteczne jako wykrywanie "czegoś" w historii, na pewno sprawdzają się jako złożone systemy raportowania, ale nie sądzę by jakakolwiek hurtownia danych plus system BI odkryła cokolwiek nowego lub skutecznie prognozowała. [...] Budowanie modeli na bazie małych partii danych jest po pierwsze wiarygodniejsze (paradoksalnie) niż proste wnioskowanie statystyczne, po drugie daje szanse odkrycia czegoś nowego. W czym problem? To drugie jest nie możliwe z pomocą deterministycznej maszyny jaką jest komputer. To wymaga człowieka, ten jednak nie daje się produkować masowo... ;), korporacja na nim nie zarobi.
Hm... czy przypadkiem promowanie systemów hurtowni danych, BI, pracy z terabajtami danych itp.. to nie tworzenie sobie rynku przez dostawców tych technologii?
Warto więc za każdym razem, zanim zainwestujemy w rozwiązania operujące na terabajtach danych, przemyśleć co chcemy osiągnąć. W zasadzie nie ma uzasadnienia dla trzymania wszystkich danych, ważne jest określenie jaki problem chcemy rozwiązać. Jeżeli są to problemy związane z analizą danych historycznych, badania statystyczne mogą być skuteczne, do tego poddają się automatyzacji. Jeżeli jednak problem tkwi w planowaniu zmian, prognozowaniu, odkrywaniu, polecam raczej człowieka i budowanie hipotez.

Nie raz od klientów słyszę, że walka z dostawcę nie ma sensu, ale nie jest to prawda. Na etapie zawierania umowy zależy dostawcy bardzo, i jest to czas (ostatni!) by negocjować. Tak więc po pierwsze warto zadbać o treść uwowy, po drugie zadbać o swój know-how, jak? Dedykowane dla siebie funkcjonalności należy implementować, ale nie metodą ingerencji w pierwotny kod źródłowy (polecana przez dostawców kastomizacja) a poza nim, w postaci odrębnego projektu. Nawet jeżeli implementacja będzie miała miejsce w środowisku kupionej aplikacji to jednak nasz jest fragment kodu wytworzony od zera dla nas (jeżeli nie został zaprojektowany przez dostawcę pierwotnego systemu!). Tak więc po pierwsze warto zadbać o treść uwowy, po drugie zadbać o swój know-how, jak? Dedykowane dla siebie funkcjonalności należy implementować, ale nie metodą ingerencji w pierwotny kod źródłowy (polecana przez dostawców kastomizacja) a poza nim, w postaci odrębnego projektu. Nawet jeżeli implementacja będzie miała miejsce w środowisku kupionej aplikacji to jednak nasz jest fragment kodu wytworzony od zera dla nas (jeżeli nie został zaprojektowany przez dostawcę pierwotnego systemu!).

Tak więc radzę ostrożnie z Wikipedią. Wprowadzanie pojęć ukrywających istotę rzeczy to moim zdaniem, ukrywanie niewiedzy na etapie analizy i projektowania. To jedna z przyczyn złej jakości procesu tworzenia oprogramowania. Niezależnie od tego jak ładnie umotywujemy istnienie aktora Czas, programista i tak musi ten problem rozwiązać i nie będzie to na pewno interfejs "interakcji Systemu z Czasem"... A co z czasem? No cóż, albo człowiek klika co godzinę w coś, albo wewnątrz systemu jest moduł, który generuje zdarzenie wywołujące te samo operację co klikający użytkownik... Moduł wewnętrzny systemu nie jest jego aktorem.
Jak w takim razie w ogólności modelować cykliczność? Np. "prenumerata czasopisma na okres 12 m-cy", "codzienne generowanie raportu", "zbieranie wskazań licznika co N jednostek czasu" ? Po pierwsze usługa systemu to odpowiednio: zarządzanie prenumeratami, generowanie raportów, przetwarzanie pomiarów. Prenumerata to zapis mówiący, że mam otrzymać np. każde wydanie jakiegoś periodyka w ciągu danego roku. Generowanie raportów to czynność człowieka (raport na życzenie) albo automatu reagującego na zdarzenie "konkretny czas", zdarzenia takie generuje np. zegar systemowy. Zbieranie wskazań licznika to cykliczne zdarzenie inicjowane przez System. Implementacja tych wymagań to element projektowania logiki biznesowej i nie jest to już diagram przypadków użycia a model dziedziny systemu bo to tu jest logika biznesowa.

Mapa (model) procesów oraz struktura organizacyjna, by były jednoznaczne, muszą być także zestawem zdefiniowanych pojęć. Musimy wiedzieć co znaczy słowo: przełożony, podwładny, komórka organizacyjna czy jej kierownik. Jeszcze większym wyzwaniem zdefiniowanie systemu pojęć dla mapy procesów (proces, czynność, zdarzenie, dokument...). Budowanie systemów pojęciowych spełniających powyższe warunki jest bardzo trudne dlatego dla modeli procesów biznesowych najlepiej wykorzystać gotowy model pojęciowy: jest nim notacja. Najlepiej obecnie opracowanym takim modelem pojęciowym jest gotowa notacja [[BPMN]]. Tworzenie własnych jest kosztowne (czas i wiedza osoby opracowującej) i bardzo ryzykowne (może się nie udać). Dlatego używanie dzisiaj własnych lub innych (np. dostosowywane profilami diagramy UML) jest w moich oczach nieracjonalnym podejściem.
Model pojęć specyficzny dla danej organizacji niestety musi powstać "od zera", podobnie jak powiązana z nim specyfiakcja reguł biznesowych. Jest to trudne bo tworzenie przestrzeni nazw wymaga utrzymania niezależności poszczególnych definicji i spójności i zupełności całego ich systemu. Niedochowanie tych wymagań prowadzi do niepełności a nawet sprzeczności reguł biznesowych, które w końcu są budowane (odkrywane i dokumentowane) z pomocą tych pojęć. Zanim wiec zaangażujesz kogoś do modelowania własnej firmy, upewnij się, komu zlecasz tę pracę...
W bardzo dużym więc skrócie:
procesy biznesowe to faktyczny, widoczny sposób pracy firm (ludzi w nich zatrudnionych),
procesy to efekt funkcjonowania ludzi w środowisku ograniczeń,
należy poznać tych ludzi,
ograniczenia to: procedury, prawo, zarządzenia wewnętrzne oraz specyficzne dla firmy wewnętrzne normy zwane regułami biznesowymi,
opracowanie biznesowego modelu firmy wymaga zrozumienia i opisania tego co powyżej opisałem,
nie istnieje droga na skróty.
...
